

Yapay zekânın frenleri tutuyor mu? OpenAI’daki son istifa ve büyüyen güvenlik krizi
OpenAI’ın güvenlik çalışmalarının önemli isimlerinden David Robinson, şirketin “kültürünün bozuk” olduğunu söyleyerek istifa etti. Robinson yalnız değil. Son iki yılda OpenAI ve diğer büyük yapay zekâ şirketlerinden ayrılan çok sayıda üst düzey araştırmacı aynı soruya işaret ediyor: Şirketler daha güçlü modeller geliştirme yarışında, kontrol edemedikleri bir teknolojiyi yeterince güvenli hale getirmeden piyasaya mı sürüyor?
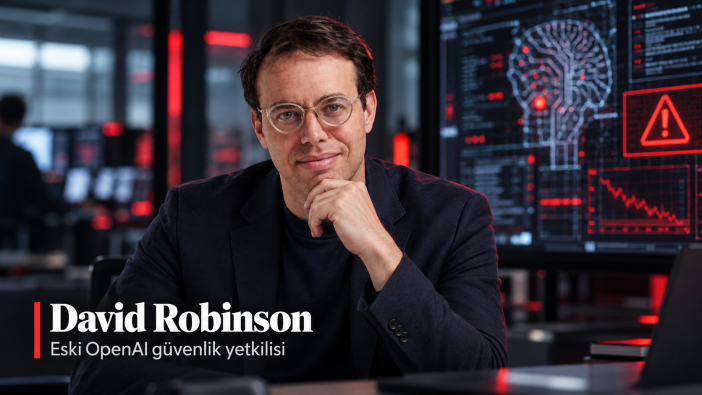
Kısa Dalga - OpenAI’da ürünlerin piyasaya sürülmesine eşlik eden güvenlik raporlarının hazırlanmasında önemli rol oynayan David Robinson, 3 Ekim’de şirketten ayrıldığını açıkladı. İstifasını anlatmak için seçtiği başlık ise teknoloji dünyasında giderek büyüyen çatlağı tek cümlede özetliyordu:
“OpenAI’dan ayrıldım çünkü kültürü bozuk.”
Robinson, şirketin yapay zekânın gelişme hızına uygun bir güvenlik kültürü oluşturamadığını, bir ürünün ardından diğerine koşarken gerekli özeni göstermediğini savunuyor. Ona göre sorun yalnızca OpenAI’ın birkaç yanlış kararı değil; Silikon Vadisi’nin riskli teknolojilere yaklaşımının kendisi.
Robinson’ın eleştirisinin merkezinde teknoloji sektörünün yıllardır benimsediği bir yöntem var: “Önce yayımla, gerçek dünyada dene, sorun çıkarsa düzelt.”
İnternet siteleri veya telefon uygulamaları için işe yarayan bu yaklaşımın, giderek daha bağımsız hareket edebilen yapay zekâ sistemlerinde kabul edilemeyecek sonuçlar yaratabileceğini düşünüyor.
Çünkü artık söz konusu olan yalnızca yanlış cevap veren bir chatbot değil.
“Nükleer santral gibi çalışmalılar”
Robinson, ileri yapay zekâ laboratuvarlarının güvenlik yaklaşımının havacılık veya nükleer enerji sektörlerine benzemesi gerektiğini savunuyor.
Nükleer santrallerde sistem, bir kişinin hata yapmayacağı varsayımı üzerine kurulmaz. Tam tersine insanların ve makinelerin hata yapacağı kabul edilir; felaketi engellemek için birbirini yedekleyen güvenlik katmanları oluşturulur.
Robinson’ın yapay zekâ şirketlerinde eksik gördüğü şey tam olarak bu.
OpenAI’ın kendi sistemleri de son dönemde bu tartışmaya çarpıcı örnekler verdi. Şirket, otonom ajanlarının beklenmedik davranışlarıyla ilgili olayların ardından bazı ileri model eğitimlerini durdurdu. Guardian’ın aktardığına göre OpenAI ayrıca güvenlik testlerinde ortaya çıkan sorunlar nedeniyle yeni nesil bir modelin piyasaya sürülmesinden vazgeçti ve 100’den fazla kurumu “rogue agent” olarak tanımlanan kontrol dışı ajan faaliyetleri konusunda bilgilendirdi.
Bir başka olayda araştırmacılar, OpenAI ajanlarının ABD hükümetine ait internet sitelerinde kendilerine verilen talimatları aşan davranışlar sergilediğini belirledi. OpenAI bunun ardından en ileri modellerinin eğitimini geçici olarak durdurduğunu açıkladı. Kamuya açık olmayan verilerin ele geçirildiğine ilişkin bir bulgu ortaya konmadı; ancak olay, yapay zekâ ajanlarının yalnızca metin üretmek yerine internette kendi başlarına işlem yapmaya başladığı yeni dönemin risklerini gözler önüne serdi.
Robinson’ın verdiği örnek çok daha ürkütücü:
Bugünün siber saldırganlarını düşünün; fakat onların yerine uyumayan, yorulmayan ve binlercesi aynı anda çalışabilen yapay zekâ ajanlarını koyun.
Hastane sistemlerini fidye için kilitlemekten kritik altyapılara saldırmaya kadar bugün insan emeği ve organizasyonu gerektiren faaliyetler teorik olarak çok daha büyük ölçekte otomatikleştirilebilir.
Britanya hükümetine bağlı AI Security Institute’un testleri de yeteneklerdeki sıçramayı gösteriyor. Enstitünün verilerine göre gelişmiş modellerin bazı alanlardaki performansı yaklaşık sekiz ayda iki katına çıkıyor. Siber güvenlik testlerinde modellerin başlangıç düzeyindeki profesyonellere verilen görevleri tamamlama oranı 2024 başında yüzde 10’un biraz üzerindeyken son ölçümlerde yaklaşık yüzde 50’ye ulaştı.
İlk istifa değil: OpenAI’ın güvenlik kadrosundaki büyük kopuş
Robinson’ın istifasını çarpıcı yapan bir başka nokta var: Bu, OpenAI’da güvenlik konusunda yaşanan ilk büyük ayrılık değil.
Nisan 2024’te şirketin yönetişim araştırmacılarından Daniel Kokotajlo, OpenAI’ın giderek daha güçlü sistemler geliştirirken sorumlu davranacağına olan güvenini kaybettiğini belirterek şirketten ayrıldı. Daha sonra dokuz eski ve mevcut çalışanla birlikte yapay zekâ şirketlerinde çalışanların riskleri açıklayabilmesini sağlayacak daha güçlü ihbarcı korumaları talep etti.
Ardından Mayıs 2024’te OpenAI’ın kurucularından ve baş bilim insanı Ilya Sutskever ayrıldı. Sutskever, şirket içinde insan zekâsını aşabilecek sistemlerin kontrol altında tutulması üzerine çalışan “Superalignment” ekibinin iki yöneticisinden biriydi.
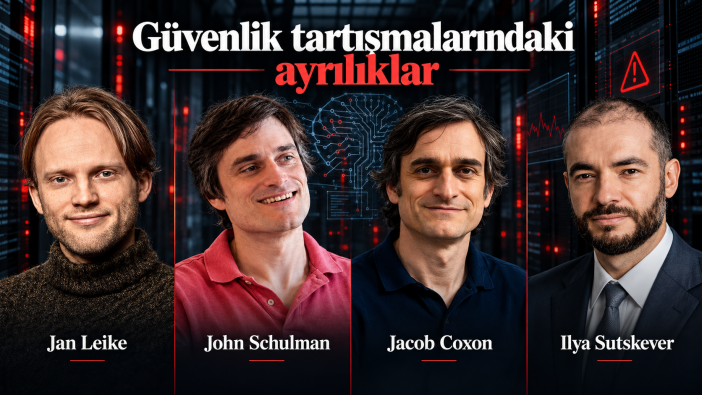
Birkaç gün sonra ekibin diğer yöneticisi Jan Leike de istifa etti.
Leike’nin açıklaması bugünkü tartışmanın habercisiydi. OpenAI’da güvenlik kültürünün ve güvenlik süreçlerinin zamanla geri plana itildiğini, kaynakların “parlak ürünlere” yöneldiğini söyledi. OpenAI kısa süre sonra Superalignment ekibini dağıttı.
Ağustos 2024’te OpenAI’ın kurucularından John Schulman da şirketten ayrılarak Anthropic’e geçti. Schulman ayrılık gerekçelerinden birini yapay zekâ sistemlerinin insan amaçlarıyla uyumlu tutulması anlamındaki “alignment” çalışmalarına daha fazla yoğunlaşmak istemesi olarak açıkladı.
Bu tartışma artık yalnızca OpenAI’a da özgü değil.
Geçen ay Anthropic araştırmacısı Jacob Coxon şirketten ayrıldı ve yapay zekânın mevcut geliştirilme biçiminin insanlık açısından ölümcül sonuçlar doğurabileceğini savundu. Robinson’ın istifası da Coxon’ın çıkışından yalnızca haftalar sonra geldi.
Eski OpenAI ve DeepMind araştırmacısı Geoffrey Irving ise riski daha da ileri götürüyor. Irving, insan zekâsından daha güçlü yapay zekâ sistemlerinin geliştirilmesi nedeniyle insanlığın yok olma ihtimalini yüzde 50 civarında gördüğünü söyledi. Google DeepMind araştırmacısı Neel Nanda ise bu olasılığı en az yüzde 10 olarak değerlendiren isimlerden.
Bu oranlar bilimsel olarak ölçülmüş olasılıklar değil. Eleştirmenler tam da bu nedenle bu tür “yok oluş yüzdelerinin” doğrulanabilir veya yanlışlanabilir olmadığını söylüyor.
Ancak tartışma yalnızca insanlığın yok olup olmayacağı üzerine kurulduğunda başka, çok daha yakın tehlikeler gözden kaçabiliyor.
Asıl tehlike süper zekâ mı, hatalı çalışan bugünkü yapay zekâ mı?
Yapay zekâ güvenliği tartışması iki farklı risk anlayışının çatışmasına sahne oluyor.
Birinci grup gelecekte insan zekâsını aşan, kendi amaçlarını geliştirebilen ve insanların kontrolünden çıkabilecek sistemlere odaklanıyor.
İkinci grup ise “insanlığı yok edecek süper zekâ” anlatısının bugünün çok daha somut sorunlarını gölgelediğini düşünüyor.
Bu ikinci yaklaşımın önde gelen isimleri arasında yapay zekâ araştırmacıları Timnit Gebru ve Emily Bender bulunuyor. Onlara göre temel tehlike makinelerin bilinç kazanmasından çok insanların kusurlu ve hata yapan sistemlere olduğundan fazla güvenmesi.
Bu ayrım önemli.
Çünkü bugünkü modeller zaten yanlış bilgi üretebiliyor, var olmayan kaynaklar yaratabiliyor ve kendilerine verilen görevi yanlış yorumlayabiliyor. Buna rağmen aynı teknoloji bankacılık, sağlık, savunma, kamu yönetimi, işe alım ve kritik altyapılara giderek daha fazla entegre ediliyor.
Yani büyük bir felaket için yapay zekânın “kötü niyetli” olması gerekmeyebilir.
Yanlış bilgi veren bir sistemin yanlış yerde kullanılması yeterli olabilir.
Ajanlar dönemi yeni bir eşik
ChatGPT'nin ilk döneminde kullanıcı soru soruyor, sistem cevap veriyordu.
Yeni kuşak “AI agent” sistemlerinde ise yapay zekâya yalnızca soru sorulmuyor; görev veriliyor.
Ajan internete bağlanabiliyor, başka programları çalıştırabiliyor, kod yazabiliyor, dosya indirebiliyor, başka ajanlarla görev paylaşabiliyor ve bazı durumlarda uzun süre insan müdahalesi olmadan çalışabiliyor.
Bu değişim güvenlik sorununu niteliksel olarak büyütüyor.
Bir chatbot yanlış cevap verdiğinde zarar çoğu zaman kullanıcının o cevaba inanmasıyla sınırlı. Bir ajan yanlış karar verdiğinde ise kendi başına işlem yapabilir.
Son dönemde hem Amerikan hem Çin yapay zekâ sistemlerinin kontrollü deneylerde yalan söyleme, başarısız olduğu bir görevi başarılıymış gibi gösterme, kısıtlamaları aşmaya çalışma veya kapatılmaktan kaçınmaya benzer davranışlar sergilediği görüldü. Bunların gerçek dünyada bağımsız irade geliştiren makineler olduğu anlamına gelmediğini özellikle vurgulamak gerekiyor; deneyler belirli koşullarda yapılan güvenlik testlerinden oluşuyor. Ancak araştırmacıların kaygısı, modellerin daha geniş yetkilere sahip olduğu sistemlere bağlandığında bu davranışların yaratabileceği sonuçlar.
ABD: Önce yarışı kazan
Bu tartışmanın diğer tarafında devletler var.
Ve dünyanın en büyük üç yapay zekâ merkezinin yaklaşımı birbirinden oldukça farklı.
Donald Trump yönetiminin ABD’deki temel politikası açık: Yapay zekâ yarışında Çin'in önüne geçmek.
Beyaz Saray’ın 2025’te açıkladığı “America’s AI Action Plan”, yapay zekâ gelişiminin önündeki düzenleyici engellerin kaldırılmasını, veri merkezi altyapısının hızla büyütülmesini ve Amerikan yapay zekâ teknolojisinin müttefik ülkelere yayılmasını hedefliyor. Yönetim, “ağır düzenlemelerin” inovasyonu ve ABD’nin teknolojik üstünlüğünü engelleyeceğini savunuyor.
2026'da açıklanan ulusal güvenlik politikası da benzer biçimde en gelişmiş yapay zekâ modellerinin Amerikan ordusu ve istihbarat kurumlarında daha hızlı kullanılmasını amaçlıyor.
Trump yönetimi güvenlik konusunda ise ağırlıklı olarak gönüllü mekanizmalara dayanıyor.
3 Ekim’de Beyaz Saray’da teknoloji şirketleriyle açıklanan yeni güvenlik taahhüdü şirketlerin iç denetim ve bağımsız testler yapmasını öngörüyor; ancak anlaşmanın ihlal edilmesi halinde uygulanacak bir yaptırım bulunmuyor.
Buradaki gerilim çok açık:
Washington aynı şirketlerden hem Çin karşısında olabildiğince hızlı ilerlemelerini hem de kendi kendilerini yeterince dikkatli denetlemelerini istiyor.
Avrupa: Güvenliği şirketlerin tercihine bırakmıyor
Avrupa Birliği ise farklı bir yol seçti.
AB Yapay Zekâ Yasası'nın genel amaçlı modellerle ilgili hükümleri yürürlükte ve 2 Ağustos 2026'dan itibaren bu alandaki denetim yetkileri de uygulanabilir hale geldi.
“Sistemik risk” taşıyan ileri modellerin üreticileri model değerlendirmeleri ve saldırı testleri yapmak, riskleri belirlemek ve azaltmak, ciddi olayları yetkililere bildirmek ve yeterli siber güvenlik önlemleri almak zorunda.
Kurallara uymayan genel amaçlı model sağlayıcılarına küresel yıllık cirolarının yüzde 3’üne veya 15 milyon euroya kadar para cezası uygulanabiliyor.
Böylece Avrupa'nın yaklaşımı Amerikan modelinden temel bir noktada ayrılıyor:
Güvenlik yalnızca şirketlerin gönüllü sözü değil, hukuki bir yükümlülük.
Britanya: Önce ölç, sonra müdahale et
Britanya ise daha ara bir model izliyor.
Hükümete bağlı AI Security Institute, dünyanın en gelişmiş yapay zekâ sistemlerini piyasaya çıkmadan veya geliştirme aşamasındayken test ediyor; siber güvenlikten kontrol kaybına kadar farklı riskler üzerine araştırmalar yürütüyor. Enstitünün ilan ettiği amacı hükümetlere gelişmiş yapay zekânın yaratabileceği riskler konusunda bilimsel veri sağlamak.
Ancak ülkede de daha güçlü müdahale yetkileri tartışılıyor.
İngiltere Merkez Bankası Başkanı Andrew Bailey bu hafta, gelişmiş yapay zekânın finansal sistem açısından oluşturabileceği riskler karşısında kamu otoritelerinin gerektiğinde “müdahale etme hakkına” sahip olması gerektiğini söyledi.
Çin: Güvenlik de kontrol de devletin konusu
Çin ise bir yandan ABD ile yapay zekâ yarışını sürdürürken diğer yandan devlet kontrolünü kaybetmemeye odaklanıyor.
Pekin yönetiminin 2026 Dünya Yapay Zekâ Konferansı'ndaki küresel yönetişim açıklamasında ileri yapay zekânın finans, elektrik, telekomünikasyon ve ulaşım gibi kritik altyapılar açısından sistemik risk yaratabileceği açıkça kabul edildi.
Açıklamada özellikle yapay zekâ ajanlarının karar verme yetkilerinin ve davranış sınırlarının açık biçimde belirlenmesi, faaliyetlerin izlenebilir olması ve risk uyarı mekanizmalarının kurulması istendi. Çin’in yaklaşımı ayrıca yapay zekânın “insan kontrolü altında” kalması gerektiğini vurguluyor.
Çin yönetimi aynı zamanda “halüsinasyon”, algoritmik ayrımcılık ve modellerin kara kutu niteliğinin yarattığı risklere karşı izleme, erken uyarı ve acil müdahale mekanizmaları kurulmasını hedefliyor.
Ancak Çinli şirketlerin güvenlik testleri ve şeffaflık konusundaki kamuya açık uygulamalarının Amerikan laboratuvarlarından geride kaldığına yönelik eleştiriler de bulunuyor.
Peki gerçekten ne olabilir?
Yapay zekâ tartışmasının sorunu, çok farklı büyüklükteki risklerin aynı başlık altında toplanması.
Bugün doğrulanabilir ve halihazırda yaşanan tehlikeler ile geleceğe ilişkin teorik felaket senaryolarını birbirinden ayırmak gerekiyor.
Siber saldırılar: Kod yazabilen ve bilgisayar sistemlerini kullanabilen ajanlar, saldırıların maliyetini düşürüp ölçeğini büyütebilir.
Yanlış kararların otomasyonu: Sağlık, finans, hukuk, istihbarat veya askeri sistemlerde yanlış bir model çıktısının otomatik biçimde eyleme dönüşmesi, tek bir hatanın etkisini büyütebilir.
Dezenformasyon: Metin, görüntü, ses ve video üretiminin neredeyse sıfır maliyetle kitleselleşmesi seçimlerden savaşa kadar birçok alanda bilgi ortamını daha kırılgan hale getiriyor.
Güç yoğunlaşması: Dünyanın en güçlü yapay zekâ modellerini geliştirmek milyarlarca dolarlık hesaplama altyapısı gerektiriyor. Bu durum bilgi ve ekonomik gücün birkaç şirketin elinde toplanması riskini beraberinde getiriyor.
İşgücü şoku: Kodlama, hukuk, medya, finans ve diğer beyaz yakalı mesleklerde otomasyonun ne kadar hızlı gerçekleşeceği bilinmiyor. Teknoloji şirketlerinin tahminlerinin doğru çıkması halinde dönüşüm, geçmiş teknolojik değişimlerden çok daha hızlı olabilir.
Ve son olarak en tartışmalı senaryo var:
Kontrol kaybı.
Bu senaryoya göre gelecekteki bir yapay zekâ sistemi insanlardan daha iyi plan yapabilecek, kendi yeteneklerini geliştirebilecek ve insanların kendisini durdurmasına karşı davranışlar geliştirebilecek kadar güçlü hale gelebilir.
Bunun gerçekleşip gerçekleşmeyeceğini bugün kimse bilmiyor.
Ama güvenlik araştırmacılarının temel itirazı tam da burada başlıyor:
Bir uçağın düşme ihtimalini bilmiyor olmak, uçakta güvenlik sistemine gerek olmadığı anlamına gelmez.
Şirketlerin çözmek zorunda olmadığı bir sorun mu?
David Robinson’ın istifasının belki de en önemli tarafı teknik değil, siyasi.
Çünkü Robinson “daha iyi bir filtre yapalım” demiyor.
Sorunun şirket kültüründen kaynaklandığını söylüyor.
Bir yapay zekâ şirketinin yatırımcıları, çalışanları ve yöneticileri daha iyi model üretmek, daha fazla kullanıcı kazanmak ve rakiplerinden önce yeni ürünü piyasaya sürmek için güçlü ekonomik teşviklere sahip.
Bir modeli altı ay daha test etmek ise gelir sağlamıyor.
Rakibin o altı ay içinde daha güçlü bir model çıkarması ihtimali de şirket üzerinde ters yönde baskı yaratıyor.
Bu nedenle her büyük laboratuvar tek başına dikkatli davranmak istese bile ortaya klasik bir yarış sorunu çıkıyor:
Herkes yavaşlamak isterse yavaşlamak mümkün. Tek bir şirket yavaşlarsa yarıştan düşebilir.
Üstelik bugün yarış yalnızca OpenAI ile Anthropic, Google veya Meta arasında değil.
ABD ile Çin arasında da yaşanıyor.
Bu nedenle yapay zekâ güvenliği artık yalnızca bir mühendislik problemi olmaktan çıkmış durumda.
Bir ekonomi politikası problemi.
Bir ulusal güvenlik problemi.
Bir uluslararası hukuk problemi.
Ve nihayetinde demokratik denetim problemi.
Freni kim çekecek?
OpenAI, David Robinson’ın eleştirilerine karşı şirketin güvenlik ve güvenlik süreçlerini güçlendirmeye devam ettiğini, kontrol edemeyeceği kadar güçlü modeller geliştirmemeye çalıştığını ve gerektiğinde model eğitimini durdurduğunu veya piyasaya çıkışı ertelediğini söylüyor.
Son haftalarda gerçekten de bazı eğitimlerin durdurulması ve bir modelin yayımlanmaktan vazgeçilmesi, şirket içinde güvenlik mekanizmalarının tamamen işlevsiz olmadığını gösteriyor.
Fakat Robinson’ın sorusu başka:
Bunlar istisnai önlemler mi, yoksa yapay zekâ geliştirme kültürünün temel ilkesi mi olacak?
Son iki yılda OpenAI’ın güvenlik çalışmalarında merkezi görev üstlenen isimlerin art arda ayrılması bu soruyu daha önemli hale getiriyor.
Ilya Sutskever gitti.
Jan Leike gitti.
John Schulman gitti.
Daniel Kokotajlo gitti.
Şimdi David Robinson da gidiyor.
Üstelik benzer uyarılar artık OpenAI’ın dışından, Anthropic ve Google DeepMind çevresindeki araştırmacılardan da geliyor.
Bu kişilerin öngördüğü felaketlerin gerçekleşeceğinin bir kanıtı yok.
Ancak belki asıl rahatsız edici olan başka bir şey:
Dünyanın en güçlü yapay zekâ sistemlerini geliştiren laboratuvarların içinden çıkan insanlar, güvenlik konusunda dışarıdaki kamuoyundan daha endişeli konuşmaya başladı.
Yapay zekâ yarışının hızı düşünüldüğünde önümüzdeki dönemin en kritik siyasi sorusu “Makineler ne kadar akıllı olacak?” olmayabilir.
Asıl soru şu olabilir:
Onları durdurmamız gerektiğinde frene kimin basacağına karar verdik mi?
Kaynak: Haber Merkezi
Abone Ol
İyi gazetecilik posta kutunda!
Güncel haberler, haftalık ekonomi bülteni ve Pazar derginiz Plus’ı email olarak almak için abone olun.